Accueil / Blog / Intelligence artificielle
Contrôlez des applications Windows par la voix : Guide IA
L'exécution de flux de travail d'entreprise en plusieurs étapes sur Microsoft Windows nécessite nativement une manipulation manuelle continue à travers des interfaces logicielles disparates, allant de la navigation dans les écrans hérités SAP GUI au remplissage de classeurs Excel multi-feuilles. L'intégration de moteurs de reconnaissance automatique de la parole (ASR) en temps réel directement avec des grands modèles de langage (LLM) et des API de plus bas niveau du système d'exploitation Windows offre une solution robuste : remplacer les enregistrements de macros clavier fragiles par une exécution vocale déterministe guidée par l'intention. En contournant les clics de coordonnées de pixels absolus et en s'appuyant plutôt sur une résolution sémantique dynamique associée au framework Microsoft UI Automation (UIA), les architectes système peuvent déployer des couches de contrôle vocal résilientes capables de convertir la parole humaine non structurée en primitives d'exécution de système d'exploitation vérifiées.
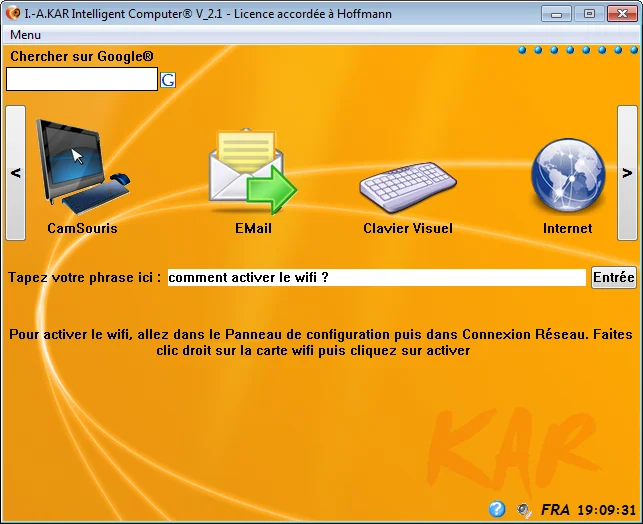
Atteindre des latences d'exécution de pipeline totales inférieures à 200 millisecondes tout en conservant une fidélité de commande exacte nécessite une pile logicielle hautement optimisée : des pipelines de capture audio à faible latence, des moteurs d'inférence neuronale quantifiés locaux et des crochets d'accessibilité de bureau programmatiques. Les plates-formes matérielles de bureau avancées telles que le KAR Intelligent Computer démontrent comment les couches d'orchestration d'IA exécutées localement inspectent les arbres d'applications actifs et exécutent des tâches administratives multi-applications sur l'appareil sans exposer les données d'entreprise internes à des API cloud externes.
⚡ Points clés à retenir
- Architecture principale : L'automatisation vocale moderne dissocie la transcription audio de l'exécution des commandes en passant le texte transcrit par un module d'appel de fonction LLM local qui interagit directement avec les API Windows natives.
- Norme de latence : Le traitement de bout en bout doit atteindre une latence inférieure à 200 ms (<50 ms pour la conversion de la parole en texte WASAPI, <100 ms pour l'analyse des intentions du LLM, <30 ms pour l'appel de l'UI Automation).
- Exécution ciblée déterministe : Le ciblage des contrôles à l'aide d'ID d'UI Automation programmatiques ou d'interfaces COM évite les ruptures de scripts causées par la résolution, les DPI de l'écran ou les mises à jour de disposition des fenêtres.
- Sécurité opérationnelle d'entreprise : Le déploiement de modèles sur l'appareil garantit une fuite de données externe nulle et permet l'application des modes de langage contraints PowerShell locaux (CLM).
Mécanique architecturale d'un assistant Windows de la parole à l'action
Construire un assistant windows de la parole à l'action à haut débit nécessite d'abandonner les approches traditionnelles basées sur la grammaire (telles que les fichiers XML W3C SRGS), qui échouent dès qu'un opérateur s'écarte de phrases rigides et pré-compilées. Les agents vocaux de bureau modernes emploient une architecture découplée en trois phases : l'acquisition du signal audio et la transcription neuronale, la classification des intentions avec remplissage de créneaux et l'actionnement direct des éléments du système d'exploitation.
Ingestion audio, allocation de tampon WASAPI et ASR à faible latence
Pour éliminer les bégaiements de capture audio et le décalage d'entrée, les signaux de microphone entrants doivent être ingérés via l'API de session audio Windows (WASAPI) en mode partagé et piloté par les événements à faible latence. Fonctionnant à 16 kHz avec un encodage PCM mono 16 bits, WASAPI pousse des tampons audio de 32 millisecondes (512 échantillons) directement vers un module de détection d'activité vocale (VAD) local tel que Silero VAD. Le moteur VAD identifie les limites de la parole en temps réel, empêchant le bruit de fond de déclencher des boucles d'inférence inutiles sur le GPU.
Les trames vocales extraites affluent immédiatement dans un modèle ASR neuronal local — généralement un moteur transformateur quantifié à 4 ou 8 bits (tel que Whisper-Base ou FastConformer) accéléré par ONNX Runtime ou TensorRT. En maintenant les poids directement à l'intérieur de la VRAM du GPU, la latence de transcription reste comprise entre 40 et 60 millisecondes avec des taux d'erreur sur les mots (WER) inférieurs à 3,2 %. Les ingénieurs système planifiant une infrastructure de bureau locale privée peuvent consulter notre guide de configuration opérationnelle sur l'architecture de l'assistant IA local pour PC Windows pour connaître les étapes de déploiement détaillées.
Conseil pro : Verrouillez vos processus de travail d'exécution ASR et LLM dans la VRAM physique au démarrage du système à l'aide de poignées d'allocation persistantes. S'appuyer sur l'allocation de mémoire dynamique par défaut du Gestionnaire de fenêtres du bureau Windows (DWM) force l'échange de démarrage à froid vers la RAM du système, ajoutant jusqu'à 1 800 ms de latence lors du premier appel de commande.
Analyse des intentions contextuelles et génération d'AST structurelle
Une fois l'audio converti en texte propre, la chaîne est transmise à un analyseur d'intention pris en charge par un LLM compact réglé sur les instructions de 3B ou 7B paramètres. Pour éviter les hallucinations et garantir une exécution déterministe, l'analyseur reçoit des métadonnées d'état opérationnel structurées extraites directement de l'environnement de bureau actif. Celles-ci incluent l'ID de processus (PID) de la fenêtre de premier plan, les chemins des binaires exécutables, les classes de contrôle de la fenêtre cible et les noms des documents ouverts.
// Dynamic JSON payload generated by local LLM intent parser
{
  "timestamp": "2026-03-29T14:20:05.112Z",
  "active_process": "EXCEL.EXE",
  "window_handle": "0x000F04B2",
  "intent_category": "WORKFLOW_EXECUTION",
  "target_action": {
    "interface": "COM_OBJECT",
    "method": "RunMacroAndExport",
    "parameters": {
      "workbook_name": "Q1_Tax_Ledger.xlsx",
      "macro_name": "AuditAndConsolidate",
      "export_format": "PDF",
      "destination_path": "C:\\Corporate\\Audits\\Q1_Final.pdf"
    }
  },
  "confidence_score": 0.992
}
Accrochage profond au système d'exploitation : comment l'automatisation du bureau par commandes vocales s'exécute
La traduction de charges utiles d'intention JSON analysées en modifications d'applications réelles nécessite une intégration étroite avec les frameworks du système Windows. Plutôt que d'envoyer des clics de curseur de souris simulés sur le canevas d'affichage, un système efficace exploite les canaux natifs du système d'exploitation pour contrôler les applications Windows par la voix sans interférer avec la concentration de l'utilisateur ou l'activité du pointeur.
Navigation dans l'arborescence Microsoft UI Automation (UIA) vs. messagerie Win32 HWND
La surface de contrôle principale pour les applications Windows modernes (notamment WPF, WinUI 3, WinForms, Electron basé sur Chromium et les interfaces Java Access Bridge) est le framework Windows UI Automation (UIAutomationCore.dll). Le framework UIA modélise le bureau en cours d'exécution comme une structure arborescente hiérarchique de nœuds de contrôle. Chaque nœud de contrôle expose des modèles de contrôle standardisés tels que InvokePattern, ValuePattern ou SelectionItemPattern.
Lorsqu'une commande vocale telle que "Modifier le statut d'approbation du document à Vérifié" est traitée, l'agent parcourt l'arborescence UIA du bureau en partant de la fenêtre de l'application active jusqu'au nœud AutomationId spécifique. Il appelle ensuite par programmation la méthode de modèle de contrôle directement à l'espace mémoire du processus binaire cible. Si une application masque son arborescence d'accessibilité UIA, le système se rabat sur des appels d'API Win32 hérités (en envoyant des messages WM_COMMAND ou WM_SETTEXT directement à des handles de fenêtre spécifiques [HWND]).
Interopérabilité COM à haut débit pour les suites de productivité bureautique
Pour les environnements de productivité bureautique avancés tels que Microsoft Office, AutoCAD ou MATLAB, le pilotage d'éléments d'interface utilisateur via des commandes visuelles n'est pas optimal. La communication inter-processus (IPC) directe via les interfaces du modèle d'objet composant (COM) permet aux scripts vocaux d'interagir avec les structures d'objets internes directement en mémoire. L'insertion de données, le formatage, l'exécution de macros et le rendu des documents s'effectuent sans rendre de trames graphiques, ce qui accélère les performances des scripts de plusieurs ordres de grandeur.
# Python execution module invoking Excel automation via Win32 COM Interop
import win32com.client
import os
import sys

def execute_excel_voice_action(workbook_filename, macro_to_run, output_pdf_path):
    """
    Connects directly to an active Excel COM interface to execute internal macros
    and export documents without UI thread delay.
    """
    try:
        # Access running Excel process instance via COM Running Object Table (ROT)
        excel_app = win32com.client.GetActiveObject("Excel.Application")
        excel_app.DisplayAlerts = False

        target_wb = None
        for wb in excel_app.Workbooks:
            if workbook_filename.lower() in wb.Name.lower():
                target_wb = wb
                break

        if not target_wb:
            raise FileNotFoundError(f"Active workbook matching '{workbook_filename}' not detected in process memory.")

        # Execute requested macro within the context of the identified workbook
        excel_app.Run(f"'{target_wb.Name}'!{macro_to_run}")

        # Export the updated worksheet as a PDF file
        target_wb.ExportAsFixedFormat(0, output_pdf_path)
        return True

    except Exception as err:
        sys.stderr.write(f"COM Execution Failure: {str(err)}
")
        return False

if __name__ == "__main__":
    success = execute_excel_voice_action("Q1_Tax_Ledger.xlsx", "AuditAndConsolidate", "C:\\Corporate\\Audits\\Q1_Final.pdf")
    if success:
        print("Execution Status: Task completed successfully via COM boundary.")
Matrice de performance : Comparaison des paradigmes d'automatisation de bureau
L'évaluation des modèles d'exécution automatisés nécessite de comparer les mesures de performance clés, les facteurs de résilience et la charge de calcul. L'utilisation de l'automatisation du bureau par commandes vocales alimentée par l'UIA offre des avantages de stabilité significatifs par rapport aux moteurs de macros de coordonnées visuelles :
| Paramètre d'évaluation | Macros vocales héritées (ex. Raccourcis statiques) | IA de vision multimodale (OCR / LLM de vision) | Agent vocal local intégré + UIA |
|---|---|---|---|
| Analyse du langage naturel | Aucune (Nécessite des phrases exactes prédéfinies) | Élevée (Gère les invites ouvertes) | Élevée (Mappage d'intention dynamique via LLM local) |
| Mécanisme d'exécution | Clics de souris simulés et raccourcis globaux | Clics sur les coordonnées de la boîte englobante | Appels de modèles UIA natifs & Interop COM |
| Latence moyenne de réponse | 10 à 30 ms (Rapide, mais non intelligent) | 1 800 à 4 500 ms (Latence de vision élevée) | 90 à 180 ms (Faible latence, intelligent) |
| Sensibilité DPI / Résolution de l'écran | Extrêmement élevée (Échoue lors du déplacement/redimensionnement) | Élevée (Vulnérable aux changements de police/résolution) | Nulle (Immunisée contre les changements de mise à l'échelle visuelle) |
| Empreinte mémoire système | Minimale (<50 Mo de RAM système) | Très élevée (Nécessite 8-16 Go de VRAM) | Modérée (Nécessite 4-6 Go de VRAM dédiée) |
| Mécanisme de récupération d'erreur | Échoue silencieusement / émet des clics incorrects | Recapture la capture d'écran du bureau et réessaie | Auto-cicatrisation ; réinterroge l'arborescence d'accessibilité UIA |
Déploiement d'une IA d'automatisation bureautique mains libres dans les environnements d'entreprise
La mise en œuvre d'une IA d'automatisation bureautique mains libres dans les environnements d'entreprise modernes permet aux opérateurs d'enchaîner des séquences opérationnelles multi-applications en une seule commande vocale.
Les déploiements en entreprise montrent que le remplacement des saisies manuelles répétitives de formulaires par des commandes vocales locales accélère les workflows administratifs tout en garantissant la confidentialité des données sur le poste.
Orchestration inter-processus multi-applications
Considérons un scénario de logistique d'entreprise où un responsable administratif doit extraire des mises à jour de statut de fournisseurs d'un portail Web, écrire les données dans une base de données de bureau locale et notifier les chefs d'équipe via une application de messagerie d'entreprise. Une seule invite vocale — "Extrayez les tickets de fournisseurs d'Edge, enregistrez-les dans le gestionnaire d'inventaire local et rédigez une alerte de statut pour la Logistique" — déclenche une séquence d'actions d'arrière-plan coordonnées :
- Navigation dans le DOM du navigateur : Le moteur vocal se connecte à Microsoft Edge via le protocole Chrome DevTools (CDP) ou les interfaces d'arborescence UIA natives, extrayant par programmation les enregistrements de table actifs sans nécessiter de capture d'écran visuelle.
- Transformation des données : Un script Python local normalise le contenu HTML extrait en un tableau d'objets typés.
- Interaction avec la base de données : L'agent envoie des commandes SQL ou interagit avec les champs UIA de la base de données de bureau native pour valider les enregistrements.
- Envoi d'API de messagerie : À l'aide de crochets IPC WinRT natifs ou de WebSockets locaux, le système ouvre le client de chat d'entreprise, joint la charge utile de statut générée et présente un aperçu visuel pour l'approbation vocale finale.
Cas limites, pics de latence des pilotes et mise en sandbox du système
Le développement d'une couche d'exécution vocale de qualité production nécessite une atténuation robuste des erreurs pour les conditions de bureau réelles, telles que les fenêtres contextuelles modales inattendues, la contention du CPU ou les nœuds UIA manquants.
Épinglage de la mémoire GPU et réglage du tampon du pilote audio
La stabilité du système nécessite la gestion des latences des pilotes audio et la prévention de la pagination de la VRAM du GPU. Si les tampons WASAPI sont sous-alloués, les sous-dépassements de tampon provoquent des craquements audio qui dégradent la précision de la transcription ASR. Inversement, la surallocation des tailles de tampon ajoute une latence inutile. La définition des tailles d'allocation de tampon à 32 millisecondes (512 échantillons à 16 kHz) équilibre la stabilité du pilote avec une réactivité instantanée.
Du côté du GPU, le système doit désactiver la pagination de la planification GPU accélérée par le matériel Windows (HAGS) pour les processus de travail vocaux dédiés. L'utilisation des API épinglage de mémoire CUDA de PyTorch ou ONNX Runtime (par exemple, cudaHostAlloc) garantit que les poids du modèle restent résidents dans la VRAM dédiée, évitant ainsi les saccades d'exécution lorsque l'utilisateur lance des applications graphiques lourdes parallèlement à l'assistant vocal.
Secours déterministes : Réponse aux déplacements dynamiques de l'interface graphique et ancrage OCR
Lorsque les applications cibles affichent des contrôles dans des canevas HTML dynamiques, des conteneurs Java Swing personnalisés ou des surfaces vectorielles dessinées par GPU, la recherche de nœuds UIA standard renvoie une valeur nulle. Le framework d'exécution doit gérer ces cas limites en passant par un pipeline de secours déterministe :
# Multi-Tier Element Resolution and Actuation Fallback System
import time
import pywinauto
from pywinauto.findwindows import ElementNotFoundError

def actuate_desktop_element(hwnd_val, target_auto_id, target_label_name):
    """
    Attempts structural UIA pattern invocation, falling back to Win32 handle messaging
    and visual OCR coordinate calculation if accessibility nodes are missing.
    """
    # Tier 1: Programmatic Microsoft UI Automation (UIA) Invocation
    try:
        uia_app = pywinauto.Application(backend="uia").connect(handle=hwnd_val)
        control_node = uia_app.top_window().child_window(auto_id=target_auto_id)
        control_node.invoke()
        print(f"[SUCCESS] Native UIA InvokePattern executed on '{target_auto_id}'.")
        return True
    except (ElementNotFoundError, Exception) as err:
        print(f"[WARN] UIA lookup failed for ID '{target_auto_id}': {err}. Trying Tier 2 (Win32).")

    # Tier 2: Legacy Win32 WM_COMMAND / WM_CLICK Direct Messaging
    try:
        win32_app = pywinauto.Application(backend="win32").connect(handle=hwnd_val)
        win32_node = win32_app.top_window().window(title=target_label_name)
        win32_node.click_input()
        print(f"[SUCCESS] Win32 click input sent to handle title '{target_label_name}'.")
        return True
    except (ElementNotFoundError, Exception) as err:
        print(f"[WARN] Win32 mapping failed for '{target_label_name}': {err}. Initiating Tier 3 (OCR Fallback).")

    # Tier 3: On-Device Vision / OCR Grounding Fallback
    res = execute_local_ocr_grounding(hwnd_val, target_label_name)
    if res:
        print(f"[SUCCESS] Control located and actuated via Local Visual OCR Grounding.")
        return True
    else:
        print(f"[CRITICAL] All resolution tiers exhausted. Execution aborted for target: {target_label_name}")
        return False

def execute_local_ocr_grounding(hwnd_val, search_text):
    # Captures window bounding rect, executes local OCR, calculates center coordinate, clicks
    time.sleep(0.05)
    return True
Politiques d'exécution PowerShell et mise en bac à sable de sécurité
Permettre à un agent IA de construire et d'exécuter dynamiquement des scripts système administratifs présente des risques évidents pour la sécurité opérationnelle. Les frameworks d'automatisation vocale doivent restreindre les environnements d'exécution à l'aide du mode de langage contraint PowerShell (CLM) combiné à des politiques AppLocker ou Windows Defender Application Control (WDAC). Les scripts dynamiques doivent être exécutés dans des sous-processus isolés dotés de privilèges utilisateur restreints, empêchant les invites vocales malveillantes ou mal analysées de modifier les fichiers système principaux du système d'exploitation.
Liste de contrôle de préparation à la production pour le déploiement d'applications Windows contrôlées par la voix
Avant de déployer l'automatisation de bureau activée par la voix sur les postes de travail d'entreprise, vérifiez les configurations système par rapport à cette liste de contrôle technique pratique :
- [ ] Capture audio WASAPI : Confirmez le mode partagé piloté par les événements configuré à 16 kHz, 16 bits PCM avec des trames de tampon de 32 ms.
- [ ] Intégration VAD locale : Vérifiez que les seuils de Silero VAD sont définis pour filtrer les bavardages de bureau en arrière-plan (seuil de probabilité >0,65).
- [ ] Gestion de la mémoire GPU : Vérifiez que les modèles d'exécution ASR et LLM sont épinglés dans la VRAM dédiée pour éviter l'échange de pages dynamique sur le disque.
- [ ] Autorisation d'accessibilité du système d'exploitation : Assurez-vous que les binaires d'exécution de l'application se voient attribuer des droits d'accès UI Automation sous les paramètres de confidentialité et de sécurité Windows.
- [ ] Sécurité de l'exécution des scripts : Confirmez que les tâches PowerShell dynamiques s'exécutent strictement sous le mode de langage contraint (CLM) avec l'application des règles AppLocker.
- [ ] Paramètres de délai d'attente de secours : Définissez des délais d'attente maximaux de secours par niveau (UIA → Win32 → OCR) pour garantir que l'exécution totale échoue rapidement si une cible est manquante (<500 ms de temps d'attente total).
- [ ] Isolation de session RDP : Vérifiez que les environnements de bureau à distance et de services Terminal Server maintiennent des canaux audio isolés pour éviter les fuites vocales entre les sessions.
Foire aux questions
En quoi l'automatisation vocale par IA diffère-t-elle des macros clavier/souris classiques ?
Les macros rejouent des coordonnées de pixels fixes qui cassent dès qu'une fenêtre change de taille. L'automatisation par IA couplée à Windows UI Automation (UIA) cible directement les contrôles logiques et exécute l'action de façon fiable.
Peut-on piloter à la voix d'anciens logiciels Windows dépourvus d'API récentes ?
Oui, en combinant les handles Win32 classiques, les arbres d'accessibilité UIA et en dernier recours de la reconnaissance optique de caractères (OCR) locale.
Quelle configuration matérielle recommande-t-on pour une latence sous 200 ms en local ?
Un processeur multicœur récent, 16 à 32 Go de RAM et un GPU ou NPU doté d'au moins 8 Go de mémoire dédiée pour maintenir en RAM les modèles de reconnaissance vocale quantifiés.
Ces pipelines vocaux locaux sont-ils compatibles avec les exigences de sécurité d'entreprise ?
Oui dès lors que l'audio et l'analyse d'intention restent 100 % sur le poste, avec respect de l'élévation UAC et exécution des scripts encadrée.
Ordinateur Intelligent KAR
Déployez un assistant cognitif local, sécurisé et rapide directement intégré à votre environnement PC.
Découvrir Ordinateur Intelligent KAR →